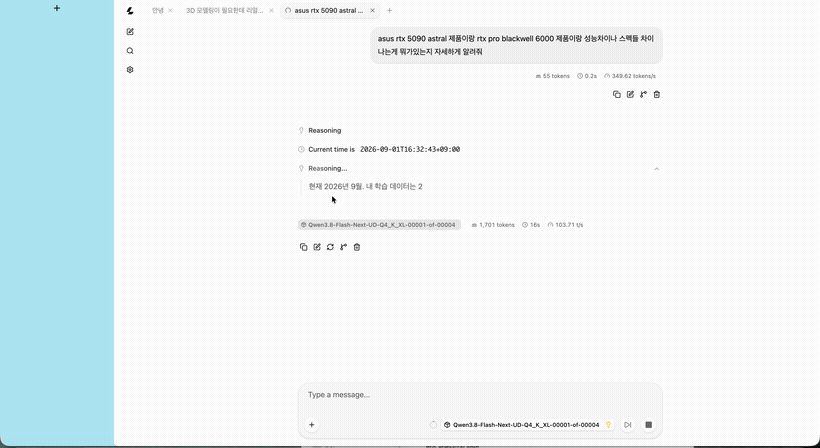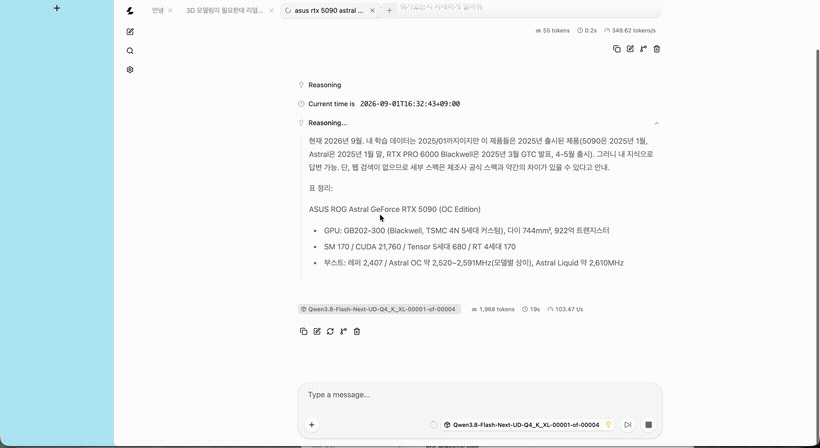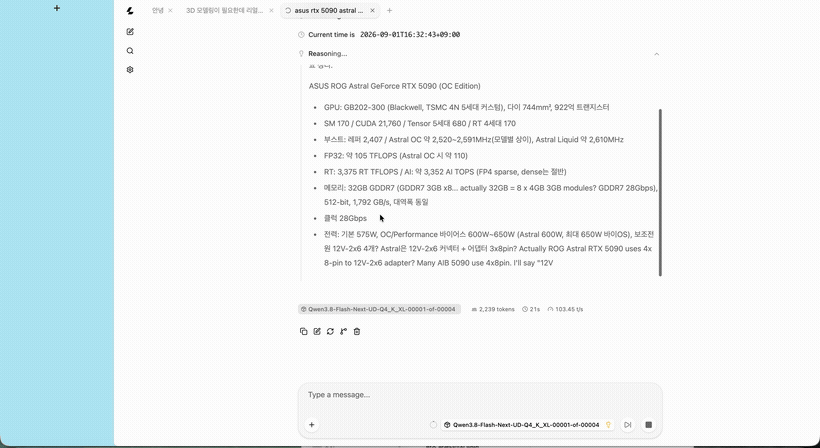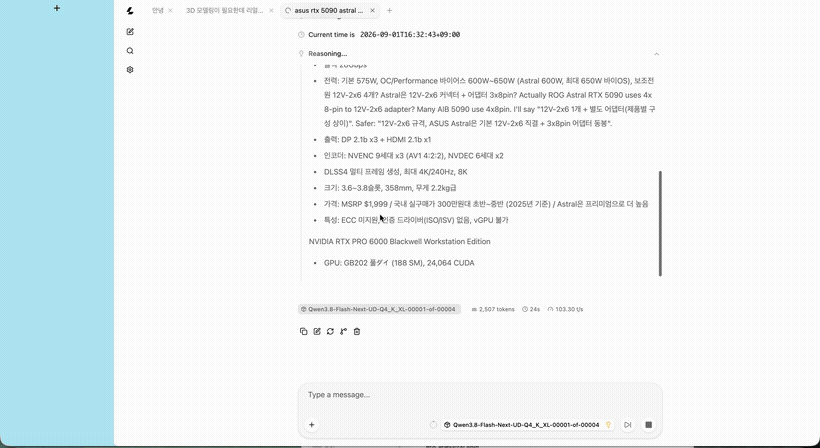
지난 글에서 RTX PRO 6000 Blackwell 96GB 사서 Qwen3.8-Flash-Next 125B를 초당 100토큰으로 돌린다고 자랑만 하고 끝냈는데, 댓글로든 어디서든 나올 질문이 뻔하다. “그래서 그거 어떻게 돌리는데?” — 이번 글이 그 상세편이다. llama.cpp 빌드부터 모델 다운로드, 벤치마크, 최종 실행 스크립트까지 전 과정을 정리했다. 셋업하면서 예상 못 한 반전이 세 번 있었는데, 그게 이 글의 재미 포인트니까 끝까지 읽어보자. 모든 수치는 내 머신(RTX PRO 6000 Blackwell + RTX 5090)에서 어제오늘 직접 실측한 값이다.
TL;DR — 알리바바가 새로 공개한 125B MoE 멀티모달 모델 Qwen3.8-Flash-Next를 llama.cpp로 로컬 구동했다. 원래 “두 GPU에 나눠 싣고 넘치는 건 RAM으로” 계획이었는데, 뚜껑을 열어보니 96GB 한 장이면 262K 풀 컨텍스트까지 들어가고, 그게 제일 빠르다. 비결은 이 모델의 26.8GiB짜리 n-gram 테이블이 llama.cpp에서 mmap lazy-read로 처리돼 VRAM에 아예 올라가지 않는다는 것. 단일 GPU에서 프롬프트 333 t/s, 생성 104 t/s.
1. Qwen3.8-Flash-Next가 뭐길래
Qwen3.8-Flash-Next는 “Qwen4 아키텍처 프리뷰”라는 부제가 붙은 실험적 모델이다. GGUF 메타데이터의 general.description에도 “A Preview of the Qwen4 Architecture”라고 박혀 있다. 스펙이 상당히 특이하다.
- 125B 파라미터 MoE, 활성은 6B — 512개 전문가 중 토큰당 10개만 활성화
- 여기에 51B짜리 n-gram 임베딩 테이블(PLE, per-layer embeddings)과 4B MTP(멀티토큰 예측) 헤드가 별도로 붙음 → BF16 원본이 330GiB
- 하이브리드 어텐션: Gated DeltaNet(선형 어텐션) + QSA(Qwen Sparse Attention), 4레이어마다 풀 어텐션 1개
- 네이티브 262,144 토큰 컨텍스트, YaRN으로 1M까지
- 이미지+비디오 입력 멀티모달 (768px 패치16 비전 인코더, 27블록)
핵심 특이점은 n-gram 테이블이다. 16개 헤드 × 각 2천만 어휘 × 160차원짜리 거대한 룩업 테이블(약 3.2억 행)인데, 토큰당 몇 행만 sparse gather로 읽는다. “파라미터는 많지만 읽는 건 찔끔”이라는 이 성격이 뒤에서 중요한 반전을 만든다.

2. 하드웨어와 목표
| 항목 | 사양 |
|---|---|
| GPU0 | RTX PRO 6000 Blackwell Workstation Edition 96GB (sm_120) |
| GPU1 | ASUS ROG Astral RTX 5090 32GB (sm_120) |
| GPU 연결 | PCIe(PHB), NVLink 없음 |
| CPU | 라이젠9 9950X3D (16C/32T) |
| RAM | 128GB (DDR5-6000 풀뱅) |
| OS | Ubuntu 24.04, 드라이버 610.43.02, CUDA 13.3 |
목표: unsloth의 UD-Q4_K_XL 양자화(103.7GiB)를 llama.cpp로 서빙하기. 당초 계획은 “두 GPU 합산 128GB VRAM에 분산 + n-gram 테이블은 RAM 오프로드”였다. 이 계획이 어떻게 무너지는지(좋은 쪽으로) 보자.
3. 셋업
3.1 llama.cpp 지원 확인 — 아키텍처 이름 함정 (반전 1)
llama.cpp 소스를 뒤지면 qwen3next라는 아키텍처가 눈에 들어오는데, 이 모델은 그게 아니다. GGUF 헤더를 읽어보면:
general.architecture = qwen4exp
general.description  = A Preview of the Qwen4 Architecture
general.size_label   = 512x56B
qwen4exp.expert_count = 512
qwen4exp.expert_used_count = 10
qwen4exp.context_length = 262144
HF 원본 config의 Qwen4ExpForConditionalGeneration에 대응하는 별도 아키텍처 qwen4exp가 llama.cpp에 정식 등록돼 있다(src/models/qwen4exp.cpp). PLE 전용 텐서 타입까지 1급 지원. 마스터 브랜치가 이 모델 관련 커밋으로 활발히 움직이는 중이라 무조건 최신 master를 빌드하는 게 맞다. 릴리즈 바이너리 기다리지 말자.
3.2 CUDA 빌드 (Blackwell sm_120)
git clone --depth 1 https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
cmake -B build -G Ninja \
  -DCMAKE_BUILD_TYPE=Release \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120 \
  -DCMAKE_CUDA_HOST_COMPILER=/usr/bin/g++-13 \
  -DCMAKE_C_COMPILER=/usr/bin/gcc-13 -DCMAKE_CXX_COMPILER=/usr/bin/g++-13
cmake --build build --config Release -j 32- CUDA 13.x 툴킷 필요 (sm_120은 CUDA 12.8부터). cmake가 알아서
120a로 치환한다 - 컴파일러는 gcc-13 사용 (우분투 24.04 기본 gcc도 되긴 하는데 CUDA 13에는 13이 무난)
- 9950X3D 32스레드 빌드로 약 2분 만에 끝났다
- 듀얼 GPU면 NCCL 없다는 경고가 뜨는데 무시해도 된다 (layer split은 NCCL 안 씀)
3.3 모델 다운로드
unsloth 리포의 양자화 라인업(실측 크기): BF16 329.7 / Q8_0 175.3 / UD-Q6_K_XL 157.5 / UD-Q5_K_XL 147.4 / UD-Q4_K_XL 103.7 / UD-IQ4_XS 87.2 / UD-Q2_K_XL 73.5 / UD-IQ1_S 67.6 GiB. 나는 품질-용량 밸런스로 UD-Q4_K_XL을 골랐다.
pip install -U "huggingface_hub[cli]"
hf download unsloth/Qwen3.8-Flash-Next-GGUF \
  UD-Q4_K_XL/Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf \
  UD-Q4_K_XL/Qwen3.8-Flash-Next-UD-Q4_K_XL-00002-of-00004.gguf \
  UD-Q4_K_XL/Qwen3.8-Flash-Next-UD-Q4_K_XL-00003-of-00004.gguf \
  UD-Q4_K_XL/Qwen3.8-Flash-Next-UD-Q4_K_XL-00004-of-00004.gguf \
  mmproj-F16.gguf \
--local-dir ~/models/Qwen3.8-Flash-Next-GGUFmmproj-F16.gguf(0.84GiB)는 비전 인코더다. 빼먹으면 텍스트 전용이 된다. 참고로 --include "UD-Q4_K_XL/*" 패턴이 hf CLI 버전에 따라 무시되는 경우가 있어서 파일명을 명시하는 쪽이 안전했다. 다운로드는 내 회선 기준 약 25분.
4. 반전 2 — n-gram 테이블은 VRAM에 올라가지 않는다
원래 계획대로 “n-gram 테이블을 RAM으로 오프로드”하려고 텐서 이름을 찾다가 두 가지 사실을 발견했다.
첫째, 이름 함정. blk.1.ple_key/ple_value 같은 텐서가 눈에 띄는데 이건 각각 {2560×320}, {2560×2560}짜리 소형 투영 행렬이다. 진짜 51B 테이블은 per_layer_token_embd.weight — {160 × 320,001,536} 형태의 단일 거대 텐서로, IQ4_NL 양자화 기준 26.8GiB다.
둘째, 진짜 반전. llama.cpp 소스에서 이 텐서는 TENSOR_READ_LAZY 플래그로 로드된다:
// src/llama-model-loader.h
static const int TENSOR_READ_LAZY = 1 << 5;
// read rows on demand instead of loading whole tensor; requires mmap for now

// src/models/qwen4exp.cpp
per_layer_tok_embd = create_tensor(tn(LLM_TENSOR_PER_LAYER_TOKEN_EMBD, "weight"),
                                   { hparams.ple_head_dim, ple_rows }, TENSOR_READ_LAZY);
즉 26.8GiB짜리 테이블은 VRAM에도 RAM에도 통째로 올라가지 않고, mmap된 GGUF 파일에서 필요한 행만 그때그때 읽힌다. 토큰당 몇 행짜리 gather니까 이렇게 해도 성능 손해가 거의 없다. 103.7GiB 파일 중 GPU에 실제로 올라가는 건 약 77GiB뿐. 내가 하려던 “RAM 오프로드”를 llama.cpp가 이미 훨씬 똑똑한 방식으로 하고 있었던 거다.
여기서 실전 규칙 두 개가 나온다:
--no-mmap금지 — lazy 경로 자체가 mmap을 요구한다-ot "per_layer_token_embd=CPU"금지 — 강제로 CPU 버퍼에 올리면 lazy read가 무력화되고, 실측으로 프롬프트 처리량이 40% 떨어졌다 (아래 벤치)
5. 벤치마크 — 한 장이 이긴다 (반전 3)
동일 조건(32K 컨텍스트, 160토큰 생성)으로 세 가지 배치를 비교했다.
| 구성 | 프롬프트 | 생성 | 피크 VRAM |
|---|---|---|---|
| 단일 GPU (PRO 6000만) | 333.1 t/s | 103.6 t/s | 79.0 GiB |
듀얼 GPU (-sm layer -ts 77,23) | 324.9 t/s | 101.1 t/s | 81.7 GiB (합산) |
| 듀얼 + n-gram 강제 CPU 오프로드 | 202.6 t/s | 96.0 t/s | — |
- 두 장에 나누면 오히려 느리다. 내 보드에서 두 GPU는 PHB(PCIe 호스트 브리지) 연결이라 레이어 경계마다 액티베이션이 PCIe를 타기 때문. NVLink가 없으면 “나눌 수 있어도 나누지 마라”
- n-gram 강제 오프로드는 최악 — lazy mmap이 이미 최적인 걸 손으로 망가뜨리는 셈
- 262K 풀 컨텍스트도 단일 GPU에 들어간다: 피크 87.5/95.6 GiB, OOM 없음

125B 모델이 생성 100 t/s를 넘기는 건 활성 6B + Blackwell 대역폭 덕분이다. 비전도 확인했다. mmproj 붙이고 이미지를 던지면 정상 인식한다(OpenAI 호환 image_url 형식). 웹UI에서 한국어 질의 시에도 생성 102 t/s가 그대로 나온다.
표준 llama-bench 결과(단일 GPU, -fa 1, r=2):
| model                      |       size | test   |            t/s |
| -------------------------- | ---------: | -----: | -------------: |
| qwen4exp A3B Q4_K - Medium | 103.68 GiB | pp512  | 734.14 ± 100.58|
| qwen4exp A3B Q4_K - Medium | 103.68 GiB | pp4096 | 836.29 ±  14.27|
| qwen4exp A3B Q4_K - Medium | 103.68 GiB | tg128  | 100.73 ±   0.74|
배치가 충분히 크면 프롬프트 처리 800 t/s대까지 나온다(위 3-way 비교의 333 t/s는 짧은 프롬프트 1회짜리 실측이라 낮게 잡힌 것). 참고로 llama.cpp가 params를 176.94B로 표기하는 건 n-gram 테이블과 MTP까지 합산해 세기 때문이다.
6. 최종 실행 커맨드
CUDA_VISIBLE_DEVICES=0 llama-server \
  -m ~/models/Qwen3.8-Flash-Next-GGUF/UD-Q4_K_XL/Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf \
  --mmproj ~/models/Qwen3.8-Flash-Next-GGUF/mmproj-F16.gguf \
  -ngl 99 -fa auto -c 262144 -t 16 -np 1 \
  --temp 1.0 --top-k 20 --top-p 0.95 \
  --jinja --host 0.0.0.0 --port 8080
각 플래그를 이렇게 잡은 이유:
CUDA_VISIBLE_DEVICES=0— 96GB 한 장만. 나눠봤자 느려진다 (§5)-c 262144— 풀 컨텍스트. 87.5GiB로 여유 있음--temp 1.0 --top-k 20 --top-p 0.95— Qwen이 GGUF 메타데이터(general.sampling.*)에 박아둔 공식 권장값. 샘플링 잘못 잡으면 루프 돈다--jinja— 이미지/비디오 블록이 든 정식 chat template 활성화-np 1— 중요. §7 참고
서버 뜨면 브라우저로 http://서버IP:8080 열면 내장 웹UI가 바로 나온다. 별도 프론트엔드 설치가 필요 없어서 요즘 llama.cpp 웹UI만 쓰게 된다. 나는 우분투 본체에 서버 띄워두고 맥북에서 접속해서 쓴다.

7. 주의사항 — 아직 이른 부분들
이 모델의 llama.cpp 지원은 병합된 지 얼마 안 됐다(2026년 8월 말). 발행 직전에 상태를 다시 확인했는데, 아래 이슈들이 여전히 열려 있다. 패턴이 뚜렷한데 전부 동시 배칭에서 터진다:
- #27780 — 지속 부하에서 그래프 빌더
ggml_abort(단일/짧은 요청은 정상) - #27911 —
-np 10동시 배칭에서 CUDA “invalid configuration argument” - #28019 — 멀티 시퀀스 replay 시 recurrent 상태 손상
그래서 -np 1(단일 슬롯)이 현재로선 알려진 버그가 없는 유일한 경로다. 나처럼 개인용으로 쓰면 아무 문제 없고, 동시 사용자를 받아야 하는 상황이면 이슈 정리 전까지 보류를 권한다.
정확도 쪽 미병합 PR도 있다 (역시 발행 시점 기준 전부 미병합):
- #27879 — QSA 블록 선택 등 correctness 수정 모음
- #27941 — 이미지 토큰이 블록 하나로 뭉개지는 버그 수정 포함
- #28068 — GDN 정규화
max→rsqrt수정
특히 #27941 때문에 비전 출력은 텍스트보다 신뢰도가 낮다고 봐야 한다. 간단한 이미지는 잘 읽지만 복잡한 이미지·장문맥·멀티이미지에서는 조용히 품질이 샐 수 있다. 몇 주 뒤 master 업데이트하고 다시 빌드하면 해결될 일이다.
8. 보너스 — 내가 쓰는 실행 스크립트
맨날 긴 커맨드 치기 귀찮아서 모드별 스크립트로 만들어뒀다. solo(기본, 제일 빠름) / dual(컨텍스트나 배치를 한 장 한계 너머로 올릴 때만) / cli(원샷 테스트용) 세 가지다.
#!/usr/bin/env bash
# ./run-qwen38.sh solo | dual | cli
set -euo pipefail
LCPP=~/llama.cpp/build/bin
DIR=~/models/Qwen3.8-Flash-Next-GGUF
MODEL=$DIR/UD-Q4_K_XL/Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf
MMPROJ=$DIR/mmproj-F16.gguf
CTX=${CTX:-262144}   # CTX=65536 ./run-qwen38.sh 처럼 오버라이드 가능

COMMON=( -m "$MODEL" --mmproj "$MMPROJ" -ngl 99 -fa auto -t 16 -c "$CTX" -np 1
         --temp 1.0 --top-k 20 --top-p 0.95 )

case "${1:-solo}" in
  solo)  export CUDA_VISIBLE_DEVICES=0
         exec "$LCPP/llama-server" "${COMMON[@]}" --jinja --host 0.0.0.0 --port 8080 ;;
  dual)  exec "$LCPP/llama-server" "${COMMON[@]}" -sm layer -ts 77,23 --main-gpu 0 \
           --jinja --host 0.0.0.0 --port 8080 ;;
  cli)   export CUDA_VISIBLE_DEVICES=0
         exec "$LCPP/llama-cli" "${COMMON[@]}" -st "${@:2}" ;;
esac
9. 정리
| 질문 | 답 |
|---|---|
| 125B MoE를 로컬에서? | 된다. 96GB 한 장이면 충분 |
| 속도는? | 프롬프트 333 t/s(배치 크면 800대), 생성 104 t/s |
| 262K 컨텍스트? | 단일 GPU에서 87.5GiB로 소화 |
| 듀얼 GPU 값어치? | NVLink 없으면 오히려 마이너스 |
| 여러 명이 같이 쓰는 서빙? | -np 1로만. 동시 배칭은 아직 지뢰밭 |
“355GB 모델”이라는 숫자에 겁먹을 필요가 없었다. MoE 활성 6B + lazy n-gram 테이블이라는 구조 덕에 실제 GPU 상주 워킹셋은 77GiB급이다. 이번에 다시 배운 교훈: 새 아키텍처가 나오면 스펙 숫자보다 런타임이 그걸 어떻게 적재하는지를 먼저 봐야 한다. 계획했던 “듀얼 GPU + RAM 오프로드”는 전부 필요 없었고, 심지어 했으면 더 느려졌을 거다.
다음 스텝은 이 머신으로 VLA 모델 파인튜닝 돌리는 거다. 그 삽질기도 정리되는 대로 올리겠다. 질문은 댓글로 — 특히 다른 양자화(IQ4_XS로 완전 온-GPU 같은 거) 벤치 궁금한 사람 있으면 돌려서 답글 달아줄게.
측정 환경: llama.cpp master(commit daef7b6, 2026-08-31), CUDA 13.3, Ubuntu 24.04. 이 글의 모든 수치는 직접 실측한 로그 기반이다.
잘 보고 갑니다