결국 질렀다. NVIDIA RTX PRO 6000 Blackwell Workstation Edition. VRAM 96GB짜리 워크스테이션 그래픽카드다. 가격은 무려 26,280,000원. 경차 한 대 값이다. 작년에 ASUS ROG Astral RTX 5090 사면서 “이걸로 몇 년은 버틴다”고 했던 게 나였는데, 1년 4개월 만에 그 위에 한 장을 더 얹어버렸다. 이번 글은 RTX PRO 6000 Blackwell 구매 후기 + 빅타워에 5090이랑 듀얼로 장착하면서 개고생한 이야기 + 램 128GB 풀뱅 오버클럭 + 로컬 LLM(Qwen3.8-Flash-Next 125B) 돌려본 실사용 후기까지 전부 담았다. 길다. 아주 길 거다.

RTX PRO 6000 Blackwell, 왜 샀나
핑계 없는 무덤 없다고, 나름의 이유가 있다. 요즘 VLA(Vision-Language-Action) 모델 쪽을 계속 파고 있다. 파인튜닝도 해보고 싶고, 새로운 VLA 모델을 직접 만들어서 훈련시켜보고 싶은 것도 있다. 그런데 RTX 5090의 32GB VRAM으로는 한계가 명확했다. 요즘 쓸만한 오픈소스 LLM/VLM은 4bit 양자화를 해도 수십 GB가 기본이고, 파인튜닝은 추론보다 메모리를 훨씬 더 먹는다. 옵티마이저 상태, 그래디언트, 액티베이션까지 올리면 32GB는 순식간에 터진다.
선택지는 대충 세 개였다. ① 5090을 한 장 더 사서 32+32 멀티GPU ② 클라우드 GPU 대여 ③ RTX PRO 6000 Blackwell 96GB 한 방. 멀티GPU는 모델 쪼개는(텐서 패러렐) 삽질이 따라오고, 클라우드는 계속 쓰면 결국 더 비싸다. 그리고 무엇보다… 단일 카드 96GB라는 로망이 있잖아. 그래서 ③이 됐다. 지갑은 울었지만 후회는 없다. 아직까지는.
구매 — 컴퓨존에서 2,628만원, 그리고 3천원짜리 타포린백
구매는 컴퓨존에서 했다. 엔비디아코리아 정품 유통 물건이고, 8월 27일에 가산점 가서 직접 방문수령했다. 2,628만원짜리 그래픽카드를 온라인 택배로 받는 건 심장에 안 좋을 것 같아서. 수령하러 가는 길이 그렇게 떨릴 수가 없었다. 결제 버튼 누를 때 손이 떨린 건 덤.

주문 내역이 좀 웃긴데, 2,628만원짜리 그래픽카드 밑에 [컴퓨존] 대형 타포린백 3,000원이 같이 찍혀 있다. 박스가 커서 들고 갈 가방이 필요했다. 2,628만 원어치 쇼핑에서 제일 가성비 좋았던 지출이 이 3천원이었다고 자신있게 말할 수 있다.

엔비디아코리아 정품이라 초록색 정품보증 카드가 들어있다. 리더스시스템즈 쪽 전문 엔지니어 기술지원에 3년 무상보증. 이 가격대 물건은 역시 정품 보증이 있어야 잠이 온다. 박스 옆면에는 RTX/Quadro 정품센터(quadro.center) 안내도 있다.

언박싱 — RTX PRO 6000 Blackwell Workstation Edition 실물
박스 디자인부터 GeForce랑 결이 다르다. 무광 블랙에 금색 “NVIDIA RTX PRO 6000 Blackwell Workstation Edition” 레터링. RGB 뿜뿜하는 게이밍 카드들 사이에서 혼자 정장 입고 서 있는 느낌이다.

실물은 놀랍게도 2슬롯이다. RTX 5090 FE처럼 앞뒤로 바람이 통과하는 플로우스루(flow-through) 이중 팬 구조인데, 두께가 게이밍 카드들 절반 수준이다. 600W짜리 카드를 2슬롯에 욱여넣은 게 신기할 따름. 마감은 말할 것도 없고, 들어보면 묵직한 게 “아 이게 2,600만원의 밀도구나” 싶다.


장착 지옥편 — Antec FLUX PRO MESH에 5090이랑 듀얼 GPU 꽂기
이번 글의 하이라이트, 고생 파트다. 내 본체는 Antec FLUX PRO MESH 빅타워고, 보드는 기가바이트 X870E AORUS XTREME AI TOP이다. 여기에 첫 번째 PCIe 슬롯에 RTX PRO 6000 Blackwell, 그 다음 슬롯에 ASUS ROG Astral RTX 5090을 꽂았다. 말로 쓰면 한 줄인데 실제로는 진짜 빡셌다.
문제는 Astral이다. ROG Astral RTX 5090은 3.8슬롯 두께에 쿼드팬, 길이 357.6mm짜리 괴물이다. 원래 혼자 있을 때도 케이스를 꽉 채우던 놈인데, 위에 RTX PRO 6000이 들어오면서 자리 싸움이 시작됐다. 결국 빅타워 바닥에 달려 있던 하단 팬 2개를 떼어냈다. Astral 밑면이 하단 팬 위를 완전히 덮어버려서 공간이 안 나온다. 팬 떼는데 손은 안 들어가고, 나사는 안 보이고… 케이스 절반을 분해했다.

사진 보면 알겠지만 위에 있는 RTX PRO 6000이 오히려 얇고, 아래 5090이 두 배쯤 두껍다. 슬롯 배치상 두 카드 사이 간격이 거의 없어서 5090 팬이 PRO 6000 뒷면에 바람을 그대로 쏘는 구조가 됐다. 전원도 만만치 않다. 둘 다 12V-2×6 커넥터에 각각 600W급이라, 작년에 2500W 파워(WIZMAX P-2500W 80PLUS Platinum) 박아둔 게 신의 한 수가 됐다. 이걸 살 때는 “2500W는 오버 아닌가” 했는데, 지금 보면 예언이었다.


참고로 이 보드는 그래픽카드 두 장을 꽂으면 CPU PCIe 레인을 나눠 쓰는 구조다. 대역폭이 반으로 주는 거 아니냐 할 수 있는데, LLM 추론은 모델을 VRAM에 한 번 올려두고 도는 거라 PCIe 대역폭 영향이 거의 없다. 훈련에서 카드 간 통신이 많아지면 이야기가 달라지지만, 그건 그때 가서 고민하기로 했다.
램 128GB 풀뱅 + EXPO 6000MT/s 성공기 (feat. 램값 폭등)
GPU만 얘기하면 섭섭하다. 이번에 램도 손봤다. 원래 KLEVV CRAS V RGB WHITE 32GB×2 = 64GB를 쓰고 있었는데, VLA 파인튜닝이나 훈련 돌릴 때 96GB VRAM 대비 시스템 램 64GB면 병목이 생길 여지가 있다. 데이터 로더, 전처리 캐시, 그리고 뒤에서 이야기할 초대형 GGUF 모델 오프로딩까지 생각하면 램은 VRAM보다 넉넉해야 한다. 그래서 같은 램 64GB 키트를 하나 더 사서 32GB×4 = 128GB 풀뱅을 만들었다.

그리고 여기서 뒷목 잡는 포인트. 이 램 키트, 작년 5월 본체 맞출 때는 365,000원이었다. 이번에 산 똑같은 키트가 1,650,000원. 1년 4개월 만에 4.5배가 됐다. AI 데이터센터들이 메모리를 쓸어가면서 DDR5 가격이 미쳐 돌아가는 중이라던데, 몸으로 체감하니까 확실히 아프더라. 아래 작년 영수증에 365,000원 찍혀 있는 거 보면 눈물이 난다. 램 살 계획 있으면 최대한 빨리 사는 걸 추천한다. 진심으로.

풀뱅을 채우고 부팅했더니 아니나 다를까, 클럭이 3600MT/s로 잡혔다. AMD 플랫폼에서 램 4개 풀뱅 꽂으면 메모리 컨트롤러 부담 때문에 JEDEC 기본 클럭 근처로 떨어지는 건 유명한 이야기다. 잠깐 당황했지만, 애초에 이럴 줄 알고 EXPO 지원되는 오버클럭 램을 산 거였다. BIOS 들어가서 EXPO 프로파일 적용하고 기도 한 번 하고 재부팅.
# 풀뱅 직후 — 3600MT/s로 다운
$ sudo dmidecode -t 17 | grep -E "Configured Memory Speed|Size:"
Size: 32 GB / Configured Memory Speed: 3600 MT/s  (×4개 전부)

# EXPO 적용 후 — 6000MT/s 만세
$ sudo dmidecode -t 17 | grep -E "Configured Memory Speed|Size:"
Size: 32 GB / Configured Memory Speed: 6000 MT/s  (×4개 전부)
됐다. 풀뱅 128GB에 6000MT/s. DDR5 풀뱅에서 EXPO 6000이 한 번에 들어가는 건 솔직히 반쯤 뽑기인데, X870E AORUS XTREME AI TOP이 메모리 전원부가 좋은 보드라 그런지 부팅 실패 한 번 없이 통과했다. 이름값 했다. 며칠째 돌리고 있는데 에러 한 번 없이 안정적이다.
최종 시스템 사양 정리

| 부품 | 모델 |
|---|---|
| CPU | AMD 라이젠9 9950X3D (16코어/32스레드) |
| 보드 | GIGABYTE X870E AORUS XTREME AI TOP |
| GPU 1 | NVIDIA RTX PRO 6000 Blackwell Workstation Edition 96GB |
| GPU 2 | ASUS ROG Astral RTX 5090 OC 32GB |
| 램 | KLEVV CRAS V RGB DDR5-6000 32GB×4 (128GB, EXPO 6000MT/s) |
| 파워 | 마이크로닉스 WIZMAX P-2500W 80PLUS Platinum |
| 쿨러 | 발키리 V360s ARGB LCD |
| 케이스 | Antec FLUX PRO MESH 빅타워 |
| OS | Ubuntu 24.04.4 LTS |
이렇게 해서 VRAM 96+32 = 128GB, 시스템 램 128GB짜리 개인용 AI 워크스테이션이 완성됐다. nvidia-smi 치면 두 장이 나란히 잡히는데, 이 화면 보려고 이 고생을 했나 싶고 그렇다.

Qwen3.8-Flash-Next 돌려보기 — 111GB 모델이 집에서 초당 100토큰
자, 이제 이 짓을 왜 했는지 증명할 시간이다. 마침 며칠 전에 나온 따끈따끈한 모델이 있다. Qwen3.8-Flash-Next. 총 125B 파라미터짜리 MoE인데 토큰당 활성 파라미터는 6B밖에 안 되는 스피드 특화 모델이다. 여기에 n-gram 임베딩 51B, MTP(멀티토큰 예측) 4B까지 붙은 실험적인 아키텍처고, 컨텍스트는 기본 262K. unsloth가 만든 UD-Q4_K_XL 4bit 양자화 GGUF가 111GB다. 111GB. 이게 일반 게이밍 카드로는 꿈도 못 꾸는 사이즈인데, 96GB VRAM이면 이야기가 달라진다.
llama.cpp의 llama-server로 띄웠다. 모델 대부분을 RTX PRO 6000 Blackwell에 올리고, VRAM을 넘어가는 부분(주로 n-gram 임베딩 쪽)은 시스템 램으로 오프로드했다. 이때 램 128GB 풀뱅이 진가를 발휘한다. 64GB였으면 스왑 지옥 갔다.

nvidia-smi를 보면 llama-server 프로세스가 90,400MiB, 그러니까 90GB를 통째로 물고 있다. 97,887MiB 중 90,997MiB 사용. 5090은 화면 출력이나 하면서 놀고 있고. 96GB짜리 카드가 가득 차는 걸 보니까 속이 다 시원하더라.
그래서 속도는? 생성 속도가 초당 100토큰 안팎으로 나온다. 프롬프트 처리(prefill)는 400토큰/s대. 몇 번을 돌려봐도 꾸준히 100~104 t/s를 찍는다. 5,800토큰짜리 장문 답변을 뽑는 데 57초. 참고로 이건 생각(thinking) 모드가 기본인 추론 모델이라 체감상 답이 더 빨리 오는 느낌이다. 아래 움짤 보면 감이 올 거다.
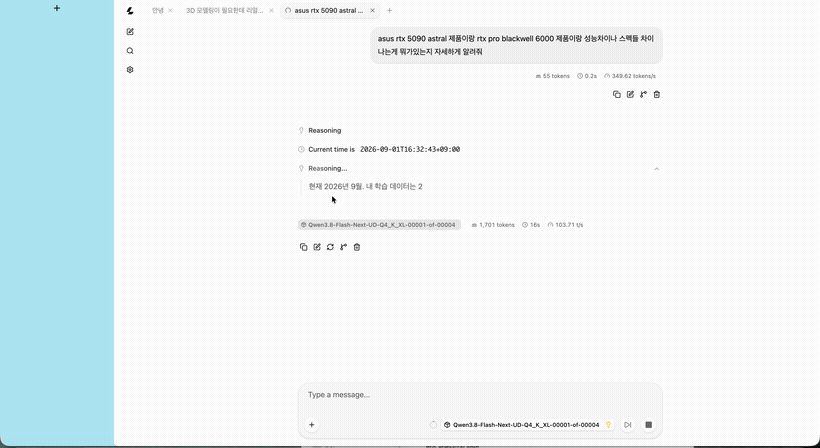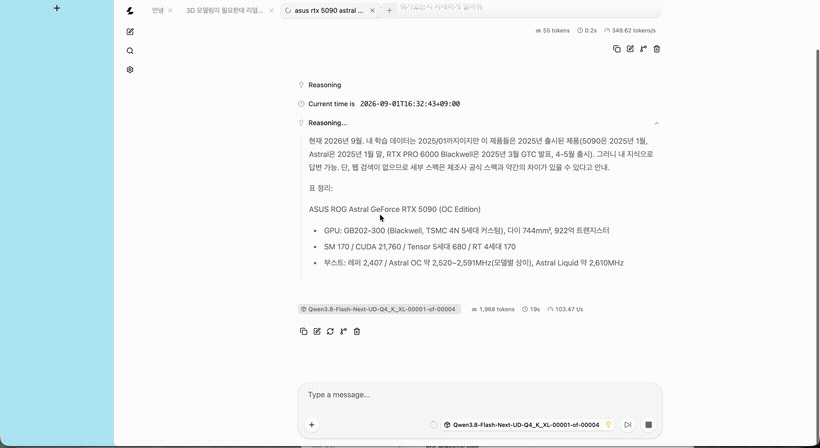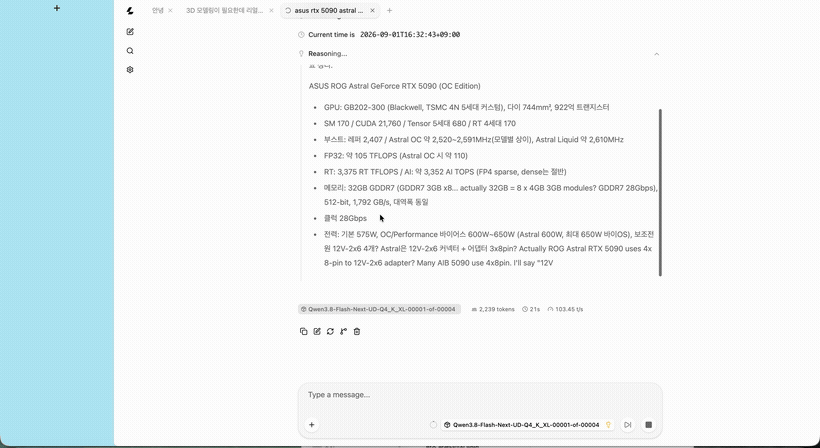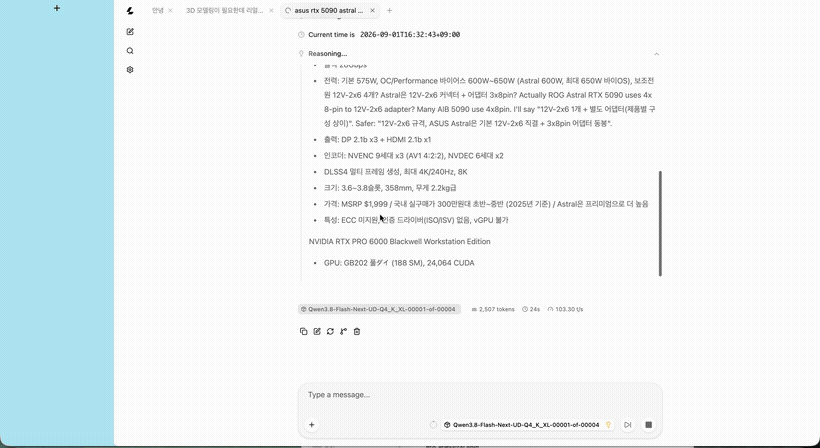
풀버전 영상도 올려둔다. 추론(Reasoning) 과정이 주르륵 흐르는 걸 보면 신기하다.

하드웨어 대비 성능 해석 — 초당 100토큰이 어느 정도냐면
“100 t/s가 빠른 거야?” 싶은 사람을 위해 하드웨어 관점에서 풀어보면 이렇다.
- 왜 125B짜리가 이렇게 빠르냐 — MoE라서다. 토큰 하나 뽑을 때 실제로 계산하는 건 활성 파라미터 6B뿐이다. 4bit 기준 토큰당 몇 GB 정도만 메모리에서 읽으면 되니까, 1,792GB/s짜리 GDDR7 대역폭이면 이론상 수백 t/s가 가능하고, 실측 100 t/s는 오프로드 오버헤드 감안하면 준수한 수치다.
- 같은 크기의 dense 모델이었다면 — 125B dense를 4bit로 돌리면 토큰당 60~70GB를 읽어야 한다. 대역폭으로 나눠보면 초당 20~25토큰이 한계다. MoE + 96GB VRAM 조합이라 100 t/s가 나오는 거다.
- RTX 5090이었다면 — 메모리 대역폭은 5090도 1,792GB/s로 똑같다. 문제는 용량. 32GB에는 이 모델의 3분의 1도 안 들어간다. 나머지 80GB를 시스템 램(수십 GB/s)에서 읽는 순간 속도는 한 자릿수로 곤두박질친다. 즉 이 모델을 “쓸 수 있냐 없냐” 자체가 VRAM 용량으로 갈린다. VRAM은 깡패다.
- 전기값 관점 — 이날 추론 도는 동안 GPU 전력이 생각보다 안 튀었다. MoE 추론은 연산보다 메모리 읽기가 많아서 600W 풀파워까지 안 간다. 클라우드 H100 인스턴스 시간당 몇 달러 내는 거 생각하면, 전기세는 애교다.
| 항목 | RTX PRO 6000 Blackwell | RTX 5090 (ROG Astral) |
|---|---|---|
| GPU | GB202 (풀칩에 가까운 188 SM) | GB202 (170 SM) |
| CUDA 코어 | 24,064개 | 21,760개 |
| VRAM | 96GB GDDR7 + ECC | 32GB GDDR7 |
| 메모리 대역폭 | 1,792GB/s (512-bit) | 1,792GB/s (512-bit) |
| FP32 | 약 126 TFLOPS | 약 105 TFLOPS |
| AI 성능 | 약 4,000 AI TOPS | 약 3,352 AI TOPS |
| 소비전력 | 600W | 575W (OC 600W) |
| 두께 | 2슬롯 | 3.8슬롯 |
| 가격(내 구매가) | 26,280,000원 | 5,899,000원 |
표로 정리하면 잔인할 정도로 명확하다. 게임이나 영상편집이 목적이면 5090이 압도적으로 합리적이다. 연산 성능 차이는 10~20% 수준이니까. RTX PRO 6000 Blackwell의 존재 이유는 딱 하나, 단일 카드 96GB VRAM이다. 70B급 이상 모델 추론, 대형 모델 파인튜닝, 그리고 나처럼 VLA 모델 훈련까지 넘보는 사람에게만 의미가 있는 카드다.
재밌는 실험 — 모델한테 직접 물어봤다
새 장난감을 받았으니 뭘 물어볼까 하다가, 방금 산 카드 이야기를 시켜봤다. “ASUS RTX 5090 Astral이랑 RTX PRO 6000 Blackwell 차이가 뭐야?”라고. 그러니까 RTX PRO 6000 위에서 돌아가는 모델이 RTX PRO 6000 스펙을 읊는, 약간 메타적인 상황이 됐다.

결론이 걸작이다. “두 카드의 연산 성능 차이는 10~20% 내외로 크지 않고, 게임은 오히려 Astral이 동급~우위. 진짜 차이는 VRAM 32GB vs 96GB, ECC 유무, ISV 인증 드라이버, 그리고 4배 이상 벌어지는 가격입니다.” — 야, 니가 지금 그 96GB 위에서 돌아가고 있는 거야. 웹 검색 없이 자기 지식만으로 대략 맞는 스펙을 뽑아내는 걸 보니 신기하기도 하고, 초당 100토큰으로 답이 쏟아지니까 클라우드 챗봇 쓰는 거랑 체감 차이가 없다.
전력, 발열, 소음
아직 풀로드 장시간 훈련은 안 돌려봐서 그 얘긴 한 달 후기로 미루고, 며칠 써본 인상만. 아이들에서 RTX PRO 6000은 7~9W, 31도 수준이다. 600W짜리 카드 맞나 싶게 얌전하다. 추론 돌 때도 블로워 팬 소음이 생각보다 조용하다. 오히려 옆에 있는 Astral 5090이 게임 돌 때 더 시끄럽다. 다만 두 장이 동시에 풀로드 걸리면 1,200W급 난로가 될 텐데, 겨울이 기대된다. 여름엔… 생각하지 말자.
장단점 정리
장점
- 단일 카드 96GB VRAM — 111GB짜리 4bit 모델이 (오프로드 살짝 끼고) 집에서 돌아간다. 이게 전부고, 이거면 충분하다
- ECC 메모리 — 파인튜닝 며칠씩 돌릴 때 비트플립 걱정을 던다
- 2슬롯 두께 — 600W 카드가 게이밍 카드 절반 두께다. 듀얼 GPU 구성이 가능했던 이유
- Qwen3.8-Flash-Next 125B가 초당 100토큰 — 로컬 LLM이 클라우드 체감속도를 따라잡았다
- 엔비디아코리아 정품 3년 보증 + 전문 엔지니어 기술지원
- 아이들 7W, 의외로 조용함
단점
- 26,280,000원 — 설명이 필요 없다
- Astral 5090이랑 듀얼 구성하려면 케이스 하단 팬을 희생해야 했다 (빅타워인데도!)
- 램값 폭등 시국이라 풀뱅 만드는 비용도 만만치 않다 (64GB 키트가 165만원)
- 이 카드가 필요한 사람은 소수다 — 게임 목적이면 그냥 5090 사자
총평 — VRAM은 깡패다
RTX PRO 6000 Blackwell Workstation Edition, 한 줄로 정리하면 “연산력이 아니라 가능성을 사는 카드”다. 5090 대비 연산이 20% 빨라서 사는 게 아니다. 32GB로는 아예 열리지 않던 문 — 70B급 풀정밀 추론, 100B급 4bit 모델, 대형 모델 파인튜닝, VLA 훈련 — 이 96GB로 열린다. 그 문값이 2천만원이라는 게 문제지만.
앞으로 이 시스템으로 VLA 모델 파인튜닝이랑 훈련 실험을 본격적으로 돌릴 예정이다. 5090은 시뮬레이션/렌더링 담당, PRO 6000은 학습 담당으로 역할 분담. 한 달쯤 굴려보고 발열, 전기세 고지서(…), 실제 파인튜닝 워크플로우까지 포함한 장기 사용기로 돌아오겠다. 로컬 LLM이나 AI 워크스테이션 맞출 계획 있는 사람들한테 조금이라도 도움이 됐길.
궁금한 거 있으면 댓글로. 특히 “이 모델 돌려봐줘” 같은 요청 환영이다. 96GB를 놀리면 아깝잖아.
로컬 LLM 세팅 팁 — 나처럼 돌리고 싶은 사람을 위해
👉 빌드부터 벤치마크까지 전 과정은 Qwen3.8-Flash-Next 로컬 구동 가이드에 따로 자세히 정리해뒀다. 여기서는 요점만.
비슷한 구성 노리는 사람들이 있을 것 같아서 세팅 포인트만 짚고 간다.
- llama.cpp + llama-server 조합을 썼다. 요즘 llama.cpp는 웹UI가 내장돼 있어서 서버 띄우고 브라우저로 접속하면 바로 채팅 화면이 나온다. 나는 우분투 본체에 서버를 띄워두고 같은 공유기에 물린 맥북에서 접속해서 쓴다. 사실상 집안용 ChatGPT 서버다.
- GPU 오프로딩은 -ngl 옵션으로 최대한 GPU에 밀어넣고, VRAM을 넘는 부분만 램으로 흘리는 게 정석이다. Qwen3.8-Flash-Next처럼 n-gram 임베딩이 거대한 모델은 그 부분을 램에 두는 걸 unsloth 쪽에서도 권장한다. 그래서 시스템 램 128GB가 필요했던 거다.
- 양자화 선택은 96GB VRAM 기준으로 UD-Q4_K_XL(111GB)이 오프로드 최소화하면서 품질을 챙기는 스윗스팟이었다. 더 작은 UD-IQ4_XS(93.7GB)면 이론상 카드 안에 통째로 들어가는데, 컨텍스트 캐시 공간을 생각하면 어차피 약간의 오프로드는 감수하는 게 낫다.
- 드라이버는 610.43.02에 CUDA 13.3 조합으로 문제 없이 잡혔다. RTX PRO 6000 Blackwell도 GeForce랑 같은 드라이버 패키지로 우분투에서 바로 인식된다. 별도의 엔터프라이즈 드라이버 설치 삽질이 없어서 좋았다.
자주 묻는 질문 (내가 나한테 물어봄)
Q. RTX PRO 6000 Blackwell로 게임 되나?
된다. GeForce 드라이버 기반이라 게임도 잘 돌아간다. 근데 게임 성능은 5090이랑 비슷하거나 클럭 때문에 살짝 밀리는 수준이라, 게임 하려고 이 돈을 쓰는 건 정신 나간 짓이다. 나도 게임은 5090으로 한다.
Q. 5090이랑 SLI처럼 묶어서 VRAM 128GB로 쓸 수 있나?
게임식 SLI는 없다. 대신 AI 워크로드에서는 두 카드를 함께 쓸 수 있다. llama.cpp나 vLLM에서 텐서/레이어 분산을 걸면 96+32를 한 풀처럼 활용하는 게 가능은 하다. 다만 카드 간 속도 차이랑 통신 오버헤드 때문에 지금은 PRO 6000 단독 + 램 오프로드가 더 깔끔했다.
Q. Max-Q 버전이랑 뭐가 다른가?
같은 96GB인데 Max-Q는 300W로 제한된 저전력·저소음 버전이다. 멀티GPU 서버에 빽빽하게 꽂는 용도. 나는 한 장으로 최대 성능을 뽑고 싶어서 600W 일반판을 골랐다.
Q. 전기세 괜찮나?
추론 위주로는 생각보다 괜찮다. MoE 추론은 GPU를 풀로 못 굴려서 실제 소비전력이 낮다. 훈련 돌리기 시작하면 이야기가 달라질 텐데, 그건 다음 달 고지서 받고 별도 보고하겠다.
Q. 어디서 사는 게 좋나?
나는 컴퓨존에서 엔비디아코리아 정품으로 샀다. 이 가격대는 병행수입 몇십만원 아끼는 것보다 국내 3년 보증이 백배 낫다고 본다. 그리고 방문수령 강추. 2,600만원짜리를 택배 아저씨 손에 맡기는 건 못 할 짓이다.
📌 함께 보면 좋은 글
- 닌텐도 스위치2 후기 — 렉사 microSD Express 1TB·프로콘2·모바패드까지 140만원 지출기
- 클릭스 파워 키보드 후기 — 7개월 기다린 Clicks Power Keyboard 솔직 리뷰
- 스위치2 AR글래스 눕겜 셋업 — 구형 독이 안 되는 이유부터 3만원 해결법까지
- Qwen3.8-Flash-Next 로컬 구동 가이드 — 125B MoE를 RTX PRO 6000 한 장으로 (llama.cpp)
이후 같은 본체의 저장 공간을 늘린 과정은 WD_BLACK SN8100 8TB 구매·윈도우와 우분투 SSD 이전 후기에 따로 정리했습니다.